Prima di chiedersi quale AI utilizzare, bisognerebbe capire se serve davvero
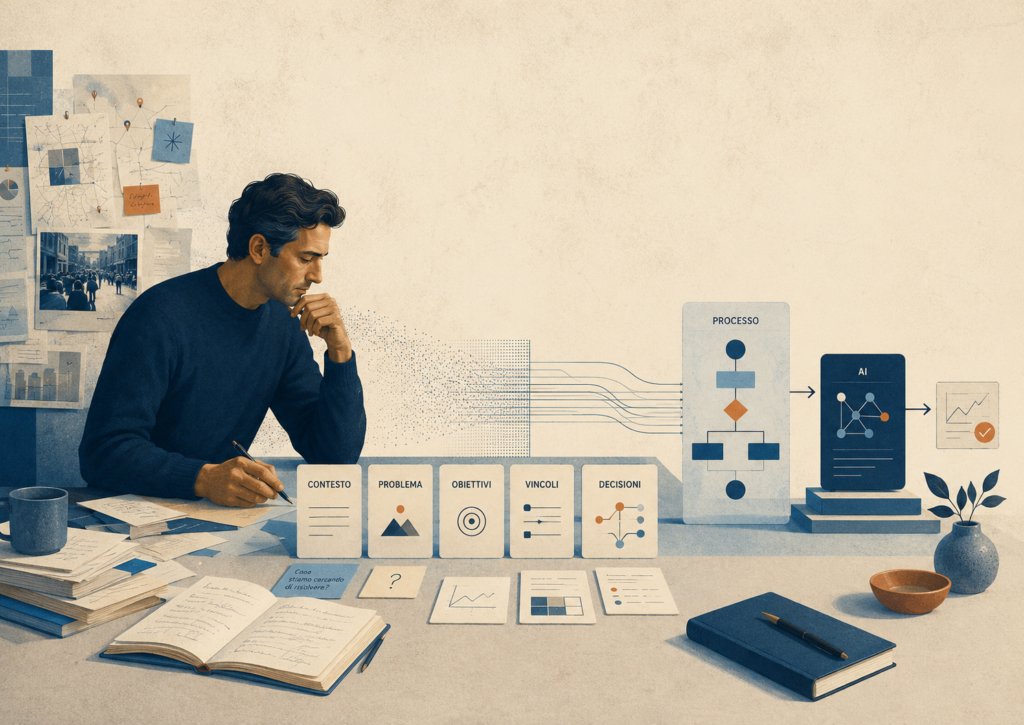
Quando si parla di intelligenza artificiale, la conversazione comincia quasi sempre dalla tecnologia.
Quale modello usi?
È meglio ChatGPT, Claude o Gemini?
Possiamo creare un agente?
Possiamo addestrare un modello con i nostri dati?
Sono domande legittime. Ma probabilmente arrivano troppo presto.
Sto iniziando ad approfondire l’intelligenza artificiale proprio da questo punto: non da come si costruisce un modello, ma da come si riconosce un problema nel quale l’AI possa produrre un risultato utile.
È una distinzione meno spettacolare di una demo, ma molto più importante.
Perché un progetto AI non fallisce soltanto quando il modello fornisce risposte sbagliate. Può fallire anche quando risolve perfettamente un problema che non aveva alcun valore, quando utilizza dati inadatti o quando viene inserito in un processo che nessuno ha realmente ripensato.
AI e automazione non sono la stessa cosa
Il primo equivoco è considerare l’intelligenza artificiale come una forma più moderna di automazione.
L’automazione tradizionale funziona particolarmente bene quando le regole sono conosciute e possono essere descritte in modo preciso:
Se accade A, esegui B.
Un sistema può ricevere un file, verificare alcuni campi, aggiornare un database e inviare una notifica. Non deve interpretare la situazione: deve applicare regole definite in precedenza.
L’AI diventa interessante quando il percorso non può essere descritto completamente con una sequenza di condizioni.
Per esempio, quando occorre:
- classificare una richiesta scritta in linguaggio naturale;
- riassumere grandi quantità di informazioni;
- individuare anomalie in comportamenti complessi;
- suggerire una possibile decisione;
- riconoscere somiglianze tra casi differenti;
- estrarre informazioni da documenti non strutturati.
La differenza non consiste quindi nel fatto che l’AI sia semplicemente “più potente”.
L’automazione esegue una regola.
L’AI interpreta un contesto e produce una previsione, una classificazione o una risposta.
In molti casi, però, la soluzione migliore utilizza entrambe.
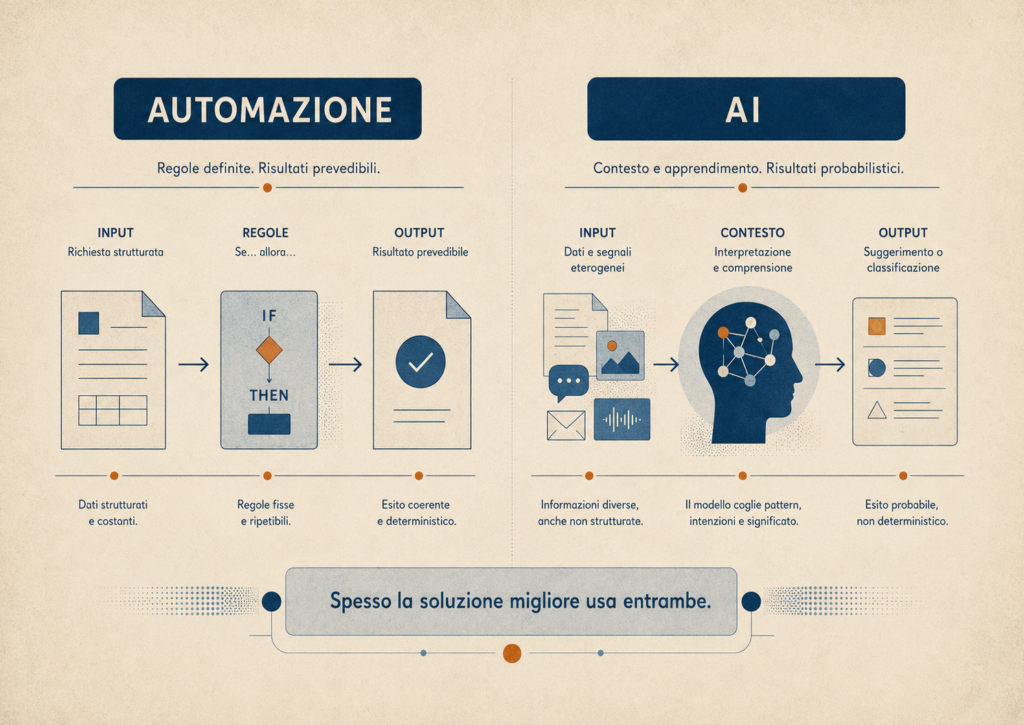
L’AI interpreta il contenuto di una richiesta, mentre un’automazione applica successivamente il processo previsto. Il valore non si trova nel modello isolato, ma nel modo in cui il modello viene inserito all’interno del sistema.
Il punto di partenza è un problema osservabile
Dire “vogliamo usare l’intelligenza artificiale” non definisce un progetto.
È un’intenzione tecnologica, non un obiettivo.
Un caso d’uso concreto dovrebbe partire da una situazione osservabile:
- gli operatori impiegano troppo tempo per classificare le segnalazioni;
- le informazioni necessarie a prendere una decisione sono distribuite in troppi sistemi;
- le anomalie vengono individuate soltanto dopo che hanno prodotto un impatto;
- documenti simili vengono analizzati manualmente centinaia di volte;
- le richieste vengono assegnate frequentemente al gruppo sbagliato;
- chi deve decidere riceve dati, ma non una sintesi comprensibile.
La domanda utile non è quindi:
Dove possiamo mettere l’AI?
La domanda utile è:
Quale attività ripetitiva, ambigua o complessa impedisce oggi alle persone di lavorare meglio?
Questo cambio di prospettiva evita di cercare problemi adatti alla tecnologia appena acquistata.
Un semplice framework per valutare un caso d’uso
Per cominciare a ragionare in modo strutturato, sto utilizzando cinque domande.
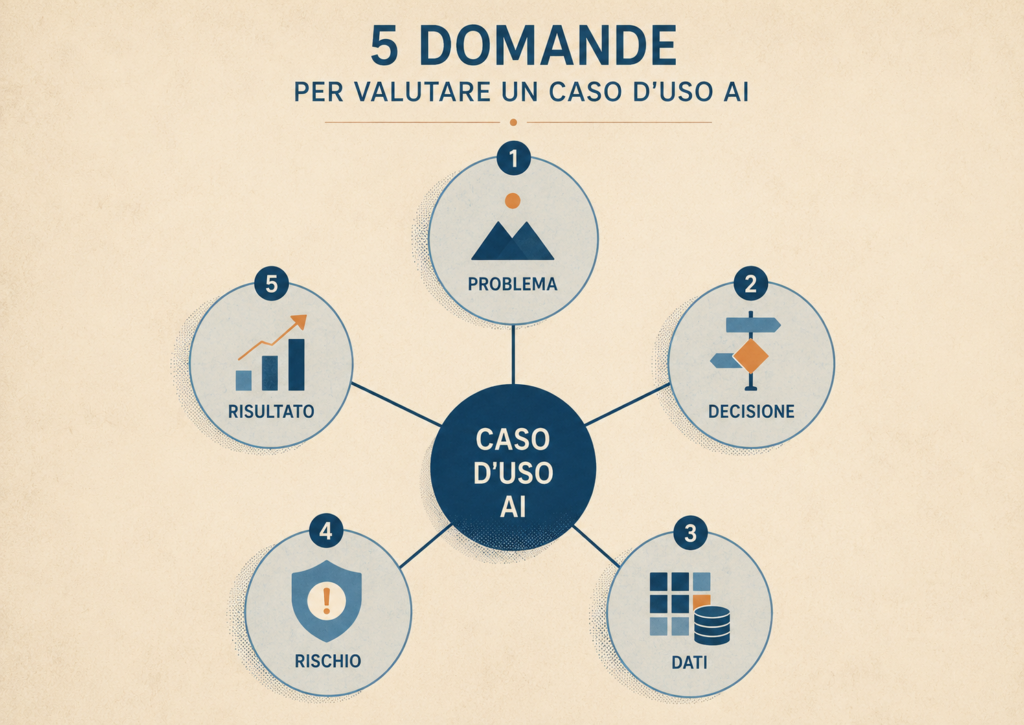
1. Qual è il problema?
Il problema deve essere specifico.
“Gestire meglio i ticket” è troppo generico.
“Ridurre il tempo necessario per leggere, classificare e assegnare i ticket ricevuti dal supporto” descrive invece un’attività, un limite e un possibile risultato.
Finché il problema non può essere spiegato senza nominare l’AI, probabilmente non è stato ancora definito abbastanza bene.
2. Quale decisione deve essere presa?
Quasi ogni caso d’uso AI supporta una decisione.
Qual è la categoria della richiesta?
Quale documento è rilevante?
Questa situazione è anomala?
Quale intervento dovrebbe essere prioritario?
Quali informazioni devono essere mostrate all’operatore?
Capire la decisione permette di distinguere un risultato interessante da un risultato realmente utilizzabile.
Un riassunto può essere scritto molto bene, ma non avere alcun valore se non aiuta nessuno a decidere o ad agire.
3. Quali dati sono disponibili?
L’intelligenza artificiale non elimina il problema dei dati. Lo rende più evidente.
Bisogna capire:
- quali informazioni esistono;
- dove sono conservate;
- quanto sono complete;
- chi può accedervi;
- se rappresentano davvero il fenomeno che vogliamo analizzare;
- se contengono errori, duplicati o informazioni sensibili.
Avere molti dati non significa necessariamente avere dati utili.
Un archivio di migliaia di ticket può sembrare una base ideale. Ma se le categorie sono state assegnate in modo incoerente, il sistema rischia di imparare proprio quell’incoerenza.
L’AI non trasforma automaticamente dati disordinati in conoscenza affidabile.
A volte li rende soltanto più convincenti.
4. Cosa succede quando il sistema sbaglia?
Questa è probabilmente la domanda più importante.
Non tutti gli errori hanno lo stesso peso.
Se un sistema suggerisce una categoria sbagliata e un operatore la corregge, il danno può essere limitato.
Se assegna automaticamente una priorità errata a un incidente critico, il rischio è molto diverso.
Prima di automatizzare una decisione bisogna stabilire:
- quanto è grave un errore;
- quanto è semplice accorgersene;
- chi può correggerlo;
- quali decisioni devono restare sotto controllo umano;
- se esiste un modo sicuro per tornare al processo precedente.
Il controllo umano non dovrebbe essere aggiunto alla fine per prudenza. Dovrebbe essere progettato insieme al sistema.
5. Come misuriamo il risultato?
Una demo può sorprendere senza produrre alcun beneficio misurabile.
Per valutare un caso d’uso servono indicatori collegati al problema iniziale:
- tempo medio risparmiato;
- riduzione degli errori;
- aumento dei casi gestiti;
- percentuale di suggerimenti accettati;
- riduzione delle riassegnazioni;
- capacità di individuare prima un’anomalia;
- qualità percepita dagli operatori.
Anche il costo deve essere considerato.
Non soltanto quello del modello, ma quello dell’integrazione, della gestione dei dati, del controllo, della manutenzione e della revisione delle risposte.
Un progetto AI genera valore quando migliora il processo nel suo complesso, non quando produce semplicemente un output tecnicamente impressionante.
Un esempio: la classificazione dei ticket
Immaginiamo un’organizzazione che riceve migliaia di segnalazioni.
Oggi un operatore legge ogni richiesta, ne identifica l’argomento, assegna una categoria e la inoltra al gruppo competente.
L’idea più immediata potrebbe essere:
Utilizziamo l’AI per gestire automaticamente i ticket.
Ma questa frase contiene ancora troppe decisioni non esplicitate.
Un approccio più prudente potrebbe essere:
- l’AI legge il testo della richiesta;
- propone una categoria e un gruppo di destinazione;
- evidenzia le informazioni che hanno determinato il suggerimento;
- l’operatore conferma o corregge;
- il sistema registra la correzione;
- soltanto dopo aver raggiunto un livello sufficiente di affidabilità, alcuni casi semplici vengono gestiti automaticamente.
In questo scenario l’AI non sostituisce immediatamente il processo.
Lo osserva, lo supporta e permette di capire dove l’automazione completa sia realmente sostenibile.
Il primo obiettivo potrebbe non essere eliminare il lavoro umano, ma ridurre il tempo necessario per svolgerlo e rendere più coerenti le decisioni.
Il vero lavoro viene prima e dopo il modello
La parte visibile di un progetto AI è spesso il modello che genera una risposta.
La parte più importante, però, comprende tutto ciò che lo circonda:
- la definizione del problema;
- la raccolta delle informazioni;
- l’integrazione con i sistemi esistenti;
- la gestione delle autorizzazioni;
- il disegno del processo;
- il controllo degli errori;
- il monitoraggio nel tempo;
- la misurazione del risultato.
Per questo l’adozione dell’AI non è soltanto un tema da sviluppatori o data scientist.
Richiede persone capaci di comprendere i processi, collegare sistemi diversi, individuare dipendenze, valutare rischi e tradurre un bisogno operativo in una soluzione verificabile.
Il modello è un componente.
Il progetto è il sistema completo.
Da dove cominciare davvero
Il primo passo per avvicinarsi all’intelligenza artificiale potrebbe quindi essere molto meno tecnologico di quanto immaginiamo.
Osservare un processo reale.
Individuare dove le persone perdono tempo, dove devono interpretare informazioni complesse e dove prendono decisioni sulla base di dati incompleti.
Poi chiedersi:
- il problema è abbastanza frequente da meritare una soluzione?
- l’AI è necessaria oppure basterebbe una buona automazione?
- i dati disponibili sono adeguati?
- il risultato può essere controllato?
- il beneficio può essere misurato?
Soltanto dopo ha senso parlare di modelli, prompt, agenti e piattaforme.
Non perché la tecnologia sia secondaria, ma perché senza un problema ben definito anche il modello migliore rimane una dimostrazione.
E una dimostrazione non è ancora una soluzione.